생성 기능 다 빼고 '결정(Decision)'에만 미친 AI 모델이 나온 이유
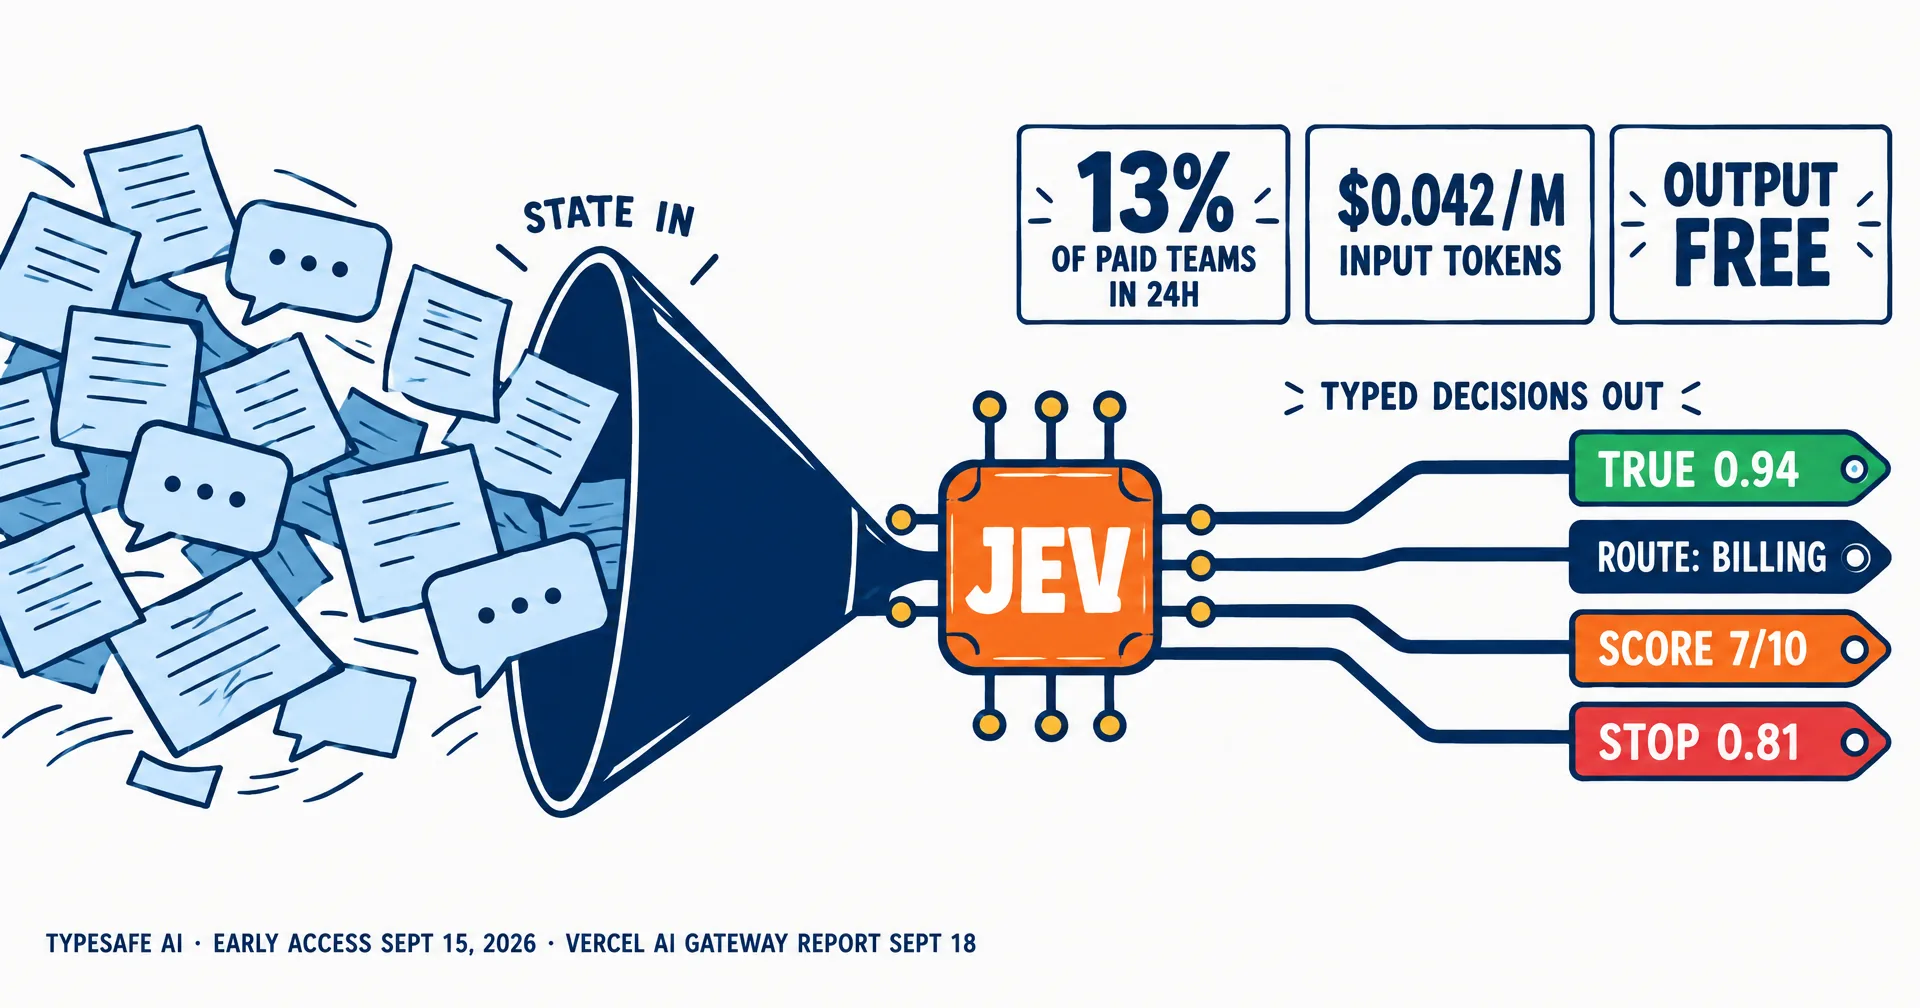
▲ 상태(State)를 입력받아 타입화된 결정(Typed Decisions)만 초고속으로 출력하는 Jev 아키텍처 개념도
요즘 AI 에이전트나 백엔드 파이프라인 만들 때 제일 골치 아픈 게 하나 있다.
유저 요청이 들어왔을 때 "이 요청이 환불 문의인가, 그냥 잡담인가?" 혹은 "다음 스텝으로 넘겨도 되는 상태인가?" 같은 단순 분류나 라우팅을 해야 하는 순간인데, 이걸 처리하자고 GPT-4o나 Claude 같은 거대한 LLM을 붙이자니 비용도 무겁고 Latency(응답 시간)도 터무니없이 느리다.
그렇다고 JSON output mode로 꾸역꾸역 타입 파싱하자니 가끔 스키마 깨져서 에러 나는 것도 스트레스다. "아니, 나는 그냥 Yes/No 판정만 필요한데 왜 문장을 길게 쓰면서 토큰을 까먹고 있지?" 싶은 순간들.
최근 오픈AI 출신이 만든 TypeSafe AI에서 공개한 Jev는 딱 이 지점을 겨냥하고 나온 모델이다.
1. "답변은 안 써요. 그냥 정해만 줍니다"
Jev의 핵심 방향성은 단순하다. 텍스트 생성(Generative) 기능을 아예 삭제했다. 문장을 지어내지 않는다.
대신 프롬프트와 상태가 주어지면, 개발자가 미리 정의해 둔 타입(Typed Options) 안에서 어떤 선택지로 분기해야 할지 확률적 판정만 빠르게 내린다. 쉽게 말해 'AI로 만든 초고속 if-else 엔진'에 가깝다.
기존 LLM처럼 "결과를 {"status": "success"} 형태의 JSON으로 반환해줘" 같은 지저분한 프롬프트 엔지니어링을 할 필요가 없다. Type Error 확률이 구조적으로 0%라는 게 개발 입장에서는 상당한 이점이다.
2. 속도와 비용: 왜 AI 라우터로 쓸까?
공개된 수치 기준으로는 프론티어 LLM 대비 속도는 최대 75배 빠르고, 비용은 1/170 수준이다.
| 비교 항목 | 일반 LLM (GPT-4o 등) | TypeSafe Jev |
|---|---|---|
| 주 역할 | 추론, 글쓰기, 코드 생성 | 분류, 라우팅, 상태 체크 |
| 출력 안전성 | 파싱 에러 및 Hallucination 위험 | 100% Type Safe (에러 0%) |
| 응답 속도 | 수 초 단위 | 밀리초(ms) 초고속 |
3. 백엔드/에이전트 'Cascade 패턴' 적용 구조
제일 이상적인 그림은 AI 파이프라인의 맨 앞단(Front-line Router)에 놓는 것이다.

▲ 라우터(Router)가 요청을 1차 분류한 뒤 적절한 핸들러로 분기하는 구조
[유저 요청 진입]
│
▼
1차: Jev 초고속 라우터 (ms 단위 / 극소 비용)
│
├── [단순 분류/상태 변경] ➔ 백엔드 DB / API 즉시 처리
└── [복잡 생성 필요] ➔ 2차: 대형 LLM (GPT-4o)에 전달
들어오는 모든 유저 요청이나 이벤트를 비싼 LLM에 바로 던지지 않고, Jev가 맨 앞에서 1차적으로 분류한다. 단순 DB 조회나 백엔드 로직으로 처리할 수 있는 문제라면 거기서 끊어버리고, 진짜 문장 작성이 필요한 10~20%의 요청만 GPT나 Claude로 넘기는 구조다.
마치며
당연하지만 만능은 아니다. Jev 자체는 검색(RAG) 능력이 있거나 배경지식을 길게 가진 모델이 아니다. 오직 주어지는 입력 Context 안에서만 판단하기 때문에, 입력 데이터 구성(State management)을 깔끔하게 넘겨주는 작업은 여전히 개발자의 몫이다.
다만 그동안 "이거 단순 분류인데 굳이 LLM 호출해야 하나?" 싶었던 찝찝함들을 해결해주는 레이어가 새로 생겼다는 점에서는 고무적이다. 앞으로 AI 백엔드 아키텍처는 **[판단 전용 소형 모델 + 생성 전용 대형 LLM]** 형태로 분리되는 게 대세가 되지 않을까 싶다.
'AI&Machine Learning' 카테고리의 다른 글
| Workflow인가 Agent인가? AI 에이전트 핵심 용어와 아키텍처 한 번에 정리하기 (D2 리뷰) (0) | 2026.10.03 |
|---|---|
| OpenAI GPT-6.1 Sol 출시: Astra 성능을 1/5 가격으로 쓰는 AI 에이전트 시대 (0) | 2026.10.01 |
| Kafka 컨슈머 리밸런스 폭풍 막기: Python async/await 비동기 처리 기법 (0) | 2026.10.01 |
| AI 에이전트 보안: 툴 응답 메시지로 데이터가 유출되는 이유 (간접 프롬프트 인젝션) (0) | 2026.09.26 |
| LLM 에이전트 개발 시 꼭 알아야 할 '침묵 실패(Silent Failure)' 분석과 방어 전략 (0) | 2026.09.25 |